AI 리더보드 순위와 업무 성과, 관계가 거의 없었어요 AI 트렌드 인사이트를 전달하는 씽킹레터입니다.
데이터로 세상을 이해하고, AI로 일의 해답을 찾는 시대가 된 지금,
글로벌 AI 트렌드와 인사이트를 사람의 손으로 적어 전달합니다. |
|
|
새 AI 모델이 나오면 성능 리더보드와 뉴스부터 찾아보시나요? 성능 점수가 다른 모델보다 높으면 '이걸로 바꾸면 당연히 나아지겠지' 하고, 쓰던 AI를 통째로 갈아타기도 하죠.
그런데 막상 업무에 붙여보면 생각만큼 달라지지 않을 수도 있어요. 리더보드는 모두가 같은 문제로 치른 성적이라, 우리 팀이 다루는 문서와 고객, 일하는 규칙까지 담고 있진 않거든요.
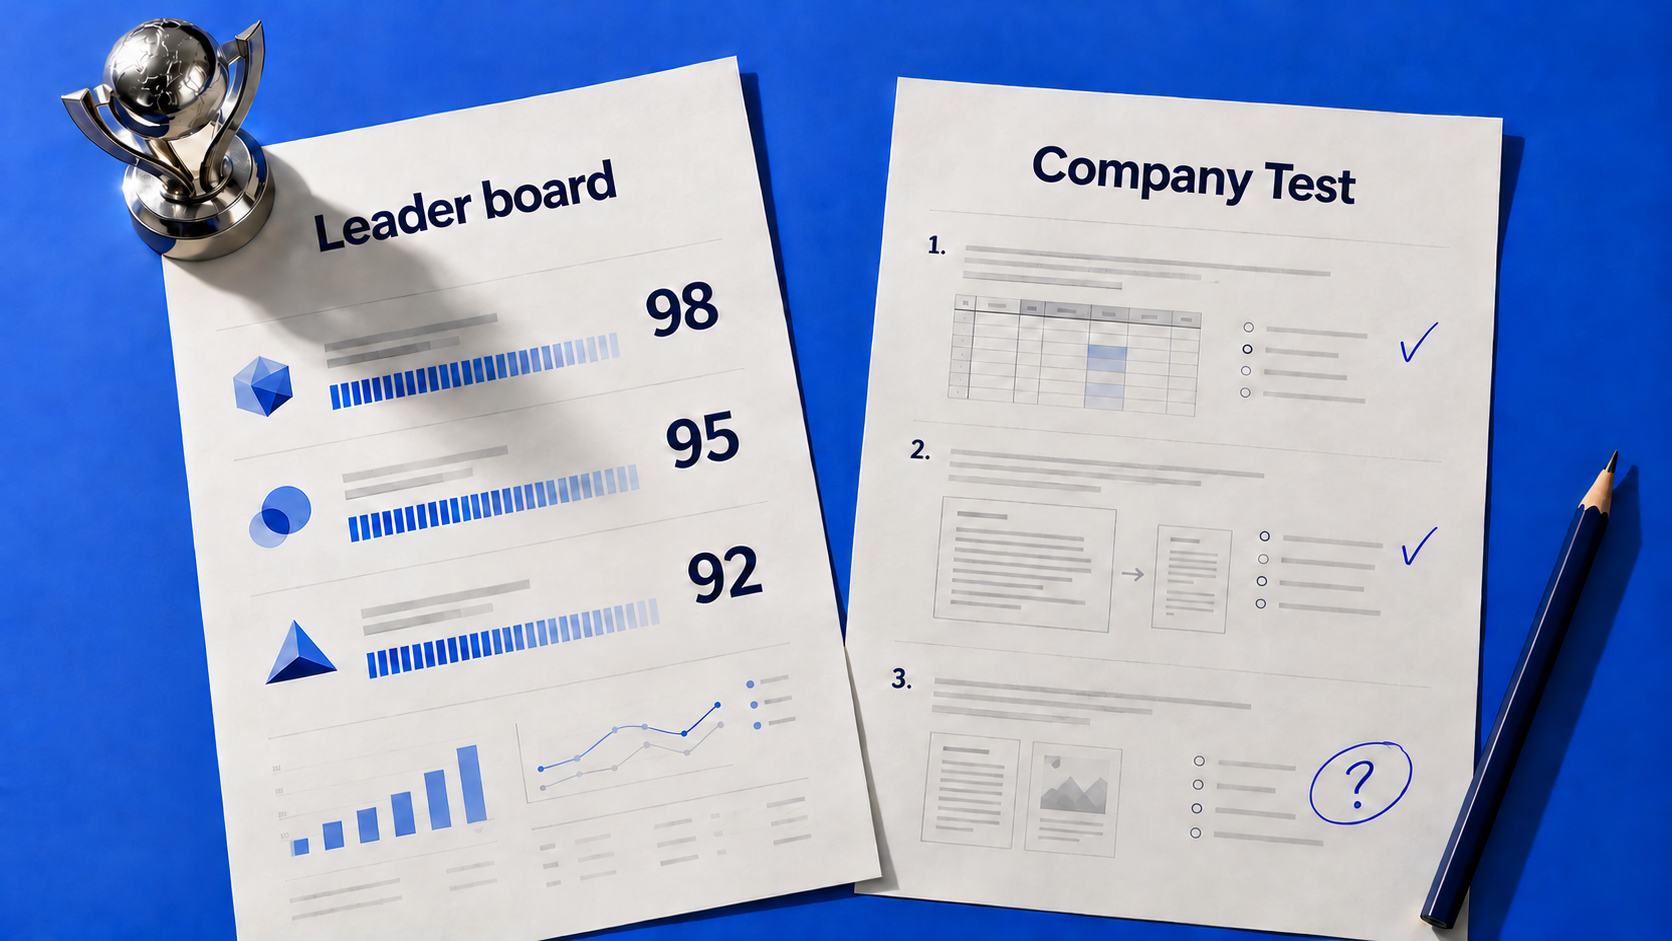
국내의 한 핀테크 기업이 모델 11개를 비교해 보니, 리더보드 순위와 실제 업무 점수 순위 사이에는 관계가 거의 없었어요. 반대로 그 회사가 자기 업무 지시문으로 직접 만든 시험의 순위는 실제 업무 순위와 꽤 비슷하게 맞았고요.
리더보드는 후보 모델을 추릴 때 여전히 쓸모 있어요. 다만 우리 업무를 잘할지는 우리 시험지로 재야 보인다는 얘기예요. 그렇다면 우리 팀 업무에 맞는 시험은 어떻게 만들 수 있을까요? |
|
|
우리 업무에 맞춘 성능표를 만드는 방법은 여러 가지가 있지만, 최근에 많이 쓰이고 있는 방식은 골든 데이터셋(Golden Dataset)이에요. AI가 반드시 제대로 처리해야 하는 실제 업무 사례와, 사람이 승인한 기대 결과나 판정 기준을 묶어 둔 표예요. AI를 가르치는 학습 자료라기보다, 실력을 확인하는 문제지에 가까워요.
온라인 쇼핑몰이 AI로 고객 문의 답변 초안을 만든다고 해볼게요. "배송 조회가 안 돼요"라는 문의에는 배송 상태를 추측하지 않고 확인 경로를 안내해야 하고, 카드 번호가 섞인 문의에는 그 번호를 답변에 그대로 따라 적지 않아야 해요. 이런 장면을 골라 '배송 상태를 단정하지 말고 조회 경로를 안내할 것', '고객이 적은 카드 번호를 답변에 다시 노출하지 말 것'처럼 눈으로 확인할 수 있는 기준과 함께 적어두는 거예요.
이런 데이터가 필요한 건, AI가 생각보다 쉽게 흔들리기 때문이에요. AI 모델, 프롬프트, 참고 문서 중 하나만 바꿔도 잘 돌아가던 업무가 무너질 수 있어요. 새 모델의 문장이 더 매끄러워 보여도 카드 번호가 노출된다면 성능이 나빠졌다는 걸 알 수 있어요. 바꾸기 전과 후에 같은 사례를 똑같이 돌려봐야, 직감이 아니라 결과로 비교할 수 있어요.
국내의 한 플랫폼 기업도 이 방식을 사내 AI 플랫폼에 녹였어요. 사람이 직접 검수한 작은 골든 데이터셋으로 기준점을 잡고, 실제 서비스 데이터로 확인할 사례를 넓히는 구조를 만들었어요. 이제는 같은 기준 위에서 모델마다 응답 속도, 비용, 정확도를 나란히 비교해 알맞은 조합을 고르고, 모든 실험 결과가 기록으로 남아요. 덕분에 같은 실험을 반복하는 일이 줄고, 결과가 흩어진 메모가 아니라 조직의 지식 자산으로 쌓이게 됐대요.
|
|
|
그런데 이 데이터를 어디서부터 채우느냐는 팀마다 달라요. 앞의 국내 사례처럼 잘 검수한 정답 사례로 기준점부터 잡는 쪽이 있고, 운영하면서 생긴 실패 사례부터 모으는 쪽이 있어요. 해외 사례를 보면 뒤쪽이 눈에 띄어요.
중국 알리바바 클라우드의 AgentLoop는 AI 에이전트가 일한 기록을 자동으로 모아 '잘한 사례'와 '실패한 사례'로 나눠 쌓아요. AI를 업데이트할 때마다 예전에 잘하던 일을 여전히 잘하는지 확인하고, 통과한 경우에만 실제 서비스에 반영하고요. 처음부터 운영 기록을 재료로 삼는 방식이죠.
Anthropic도 AI 에이전트를 평가할 문제를 만들 때 처음부터 수백 개를 갖출 필요는 없고, 실제 실패에서 뽑은 간단한 문제 20~50개면 좋은 출발이라고 했어요. 미룰수록 만들기 어려워진다는 경고도 덧붙였고요. 에어비앤비와 GitHub 출신 머신러닝 엔지니어 해멀 후세인(Hamel Husain)도 비슷한 이야기를 해요. 많은 팀이 설계도와 도구부터 붙잡지만, AI를 더 잘 쓰게 만드는 일 중 가장 남는 장사는 AI가 실제로 내놓은 답을 하나하나 읽으며 어디서 틀리는지 찾는 일이라고요.
다만 어느 쪽이 정답인 건 아니에요. 기준 없이 실패만 모으면 끝없는 두더지 잡기가 되고, 실패를 반영하지 않는 골든 데이터셋은 금방 낡아요. 잘 만든 기준점 위에, 실패를 꾸준히 더해 가는 것이 둘의 장점을 함께 챙기는 길이에요. |
|
|
물론 골든 데이터셋을 통과했다고 AI가 모든 상황에서 안전하다는 보증은 아니에요. 미리 담아두지 못한 새로운 질문이나 드문 예외는 따로 지켜봐야 해요. 정책과 가격, 업무 절차가 바뀌면 기대 결과도 함께 고쳐야 하고요. 낡은 데이터는 오히려 새 모델을 잘못 평가하게 만들거든요.
그래서 이 데이터는 한 번 써두는 문서보다 계속 쌓아가는 자산에 가까워요. 시작은 거창하지 않아도 돼요. 내가 AI에게 자주 맡기는 업무 하나를 골라 실패하면 안 되는 장면부터 입력, 기대 결과, 확인 항목, 통과 여부로 적어보는 거예요. 실패 사례는 어디서 왜 생겼는지까지 함께 남겨두고요. 사례가 쌓이기 시작하면 이력이 사라지지 않는 곳으로 옮길 차례예요.
실패를 찾을 곳도 생각보다 가까이 있어요. 사용자가 같은 질문을 다시 하거나, 중간에 나가버리거나, AI가 만든 결과를 고치거나, 상담원 연결을 누른 순간이요. 이런 행동 신호가 실패 사례의 후보가 될 수 있어요.
다음 모델이 나왔을 때, 리더보드보다 먼저 펼쳐볼 시험지가 있나요? 가장 좋은 시험 문제는 이미 AI의 대답 속에, 고객들의 행동 속에 숨어 있을지 몰라요. |
|
|
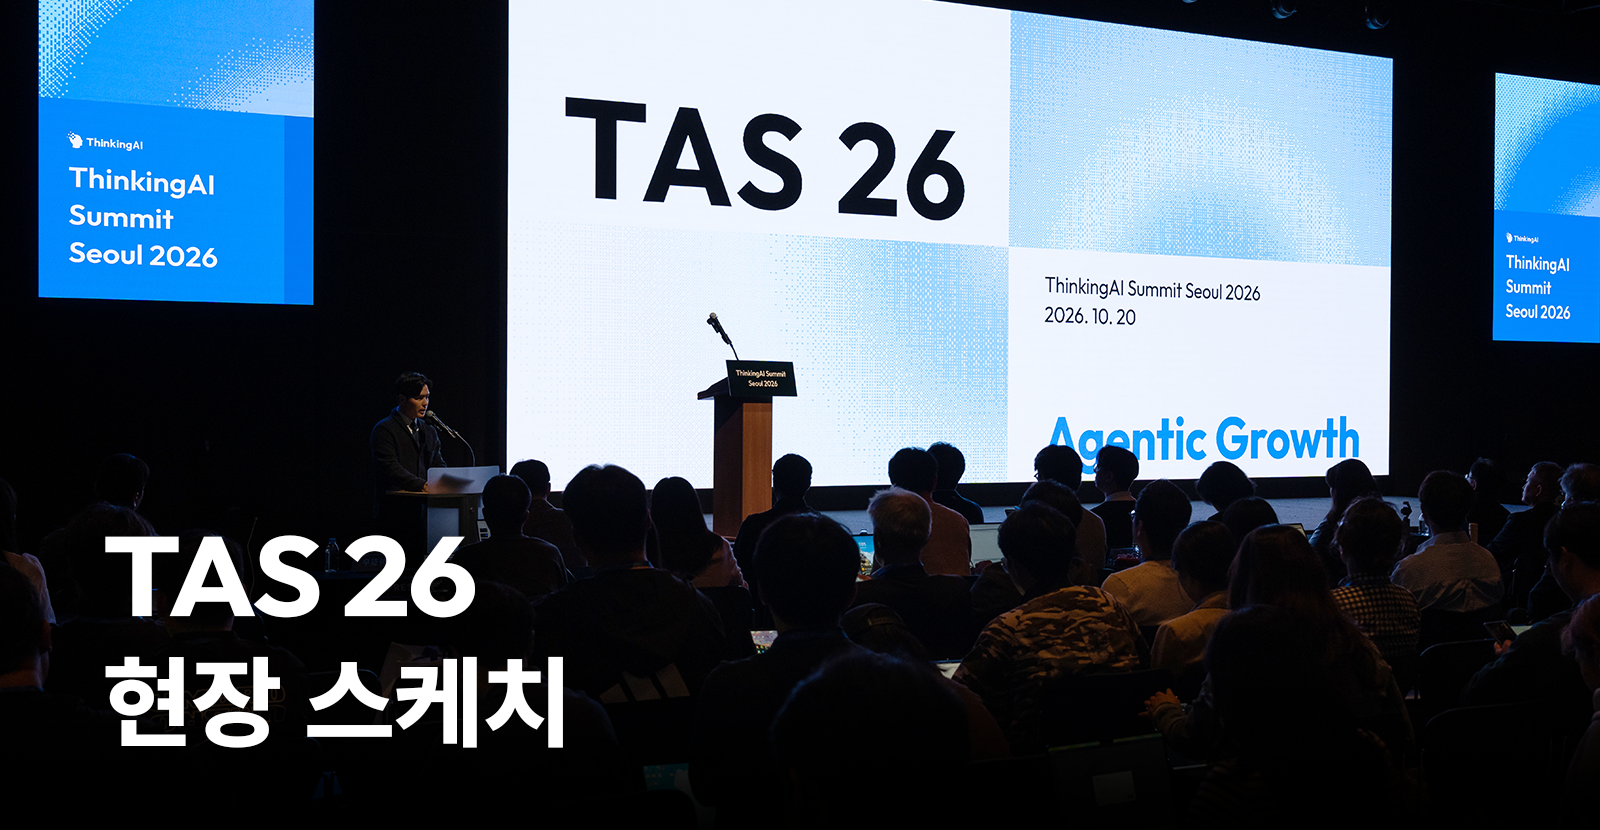
모델을 바꾸기 전에 쌓아 둘 것이 있다는 이야기, 지난 10월 20일 ThinkingAI가 연 컨퍼런스 ‘TAS 2026’ 현장에서도 이어졌어요. 400명 가까이 모인 자리에서 AI 에이전트에게 실제로 일을 맡겨 본 팀들이 성공한 숫자만큼이나 줄지 않은 시간을 솔직하게 꺼내 놓았거든요.
1~2주 걸리던 분석이 하루로, 2~3시간 걸리던 A/B 테스트 사전 검증이 15분으로 줄었어요. 그런데 사람끼리 이해시키고 승인받는 시간, AI가 낸 숫자를 검증하는 시간은 줄지 않았대요. 그 차이는 어디서 갈렸을까요? 현장의 숫자와 사례를 아티클에 정리했어요. |
|
|
|